Le problème
Environ 44 600 visites cliniques d'à peu près 5 600 patients. Pour chaque visite, prédire le score moteur de la maladie mesuré sans médicament. Les patients du test n'apparaissent jamais dans l'entraînement : le modèle doit se généraliser à de nouvelles personnes, pas se souvenir des anciennes.
Travailler avec Bob
Le cours imposait que chaque soumission sorte de Bob, le gestionnaire d'agents d'IBM, et que chaque résultat soit enregistré dans Skore Hub de Probabl. Bob n'est pas un assistant de conversation comme Claude ou ChatGPT. Il déroule un flux de compétences fixé : explorer les données, écrire une note de conception, lancer l'expérience, consigner le résultat dans un journal. Il est pensé avec une tout autre idée de ce qu'est l'outil, et apprendre à travailler dans ses règles faisait partie de l'exercice.
Mesurer honnêtement
Dès la deuxième expérience, chaque score vient d'une validation croisée en cinq blocs, groupée par patient. Mélanger les visites au hasard aurait laissé le modèle voir le même patient à l'entraînement et en validation, et donné des chiffres flatteurs que Kaggle aurait ensuite démentis.
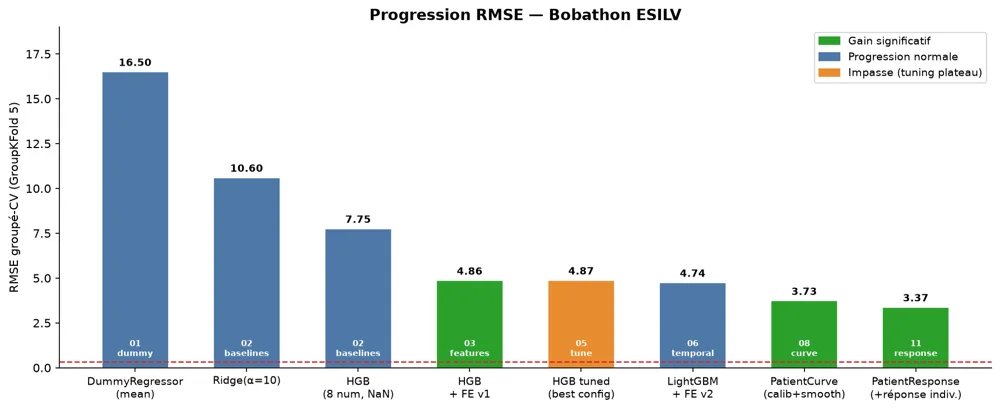
De 16,5 à 3,4
- Une prédiction constante : 16,5. Un modèle linéaire : 10,6. Du gradient boosting qui garde les valeurs manquantes comme information : 7,8.
- Des variables par patient, comme les moyennes sur toutes ses visites : 4,9. Le plus grand pas d'un coup.
- Régler le boosting et essayer un pipeline tabulaire automatique n'a rien donné. Des variables temporelles avec LightGBM : 4,7.
- Le tournant : le score de chaque patient suit une courbe régulière avec l'âge. Ajuster cette courbe par patient, puis corriger selon le temps depuis la dernière prise et selon l'évaluateur de la visite : 3,7.
- Ajouter la réponse propre à chaque patient à la lévodopa : 3,4 en validation croisée, 3,20 sur le classement public.
Ce que j'en retiens
- Regarder les données patient par patient nous a plus appris que n'importe quel réglage.
- Un découpage de validation propre compte plus que le modèle : c'est lui qui rendait chaque étape fiable.
- Tenir un journal de chaque expérience, ratées comprises, rendait le chemin facile à retracer.
- Pas fait : prédire directement les coefficients de la courbe, ou mettre LightGBM à l'intérieur du modèle par patient.